07 DMA
up的视频讲解沿着“谁来搬、搬到哪里、怎样连续搬”的顺序,理解直接内存访问与缓冲。
1 为什么把数据搬运交出去
ADC 转换完成后,结果需要进入内存;串口发送前,内存中的数据需要送到外设。如果每次都由 CPU 读取再写入,重复搬运会占用程序执行时间。
DMA 是直接内存访问控制器。CPU 先配置搬运规则,DMA 再按照请求执行传输,让 CPU 可以处理其他工作。
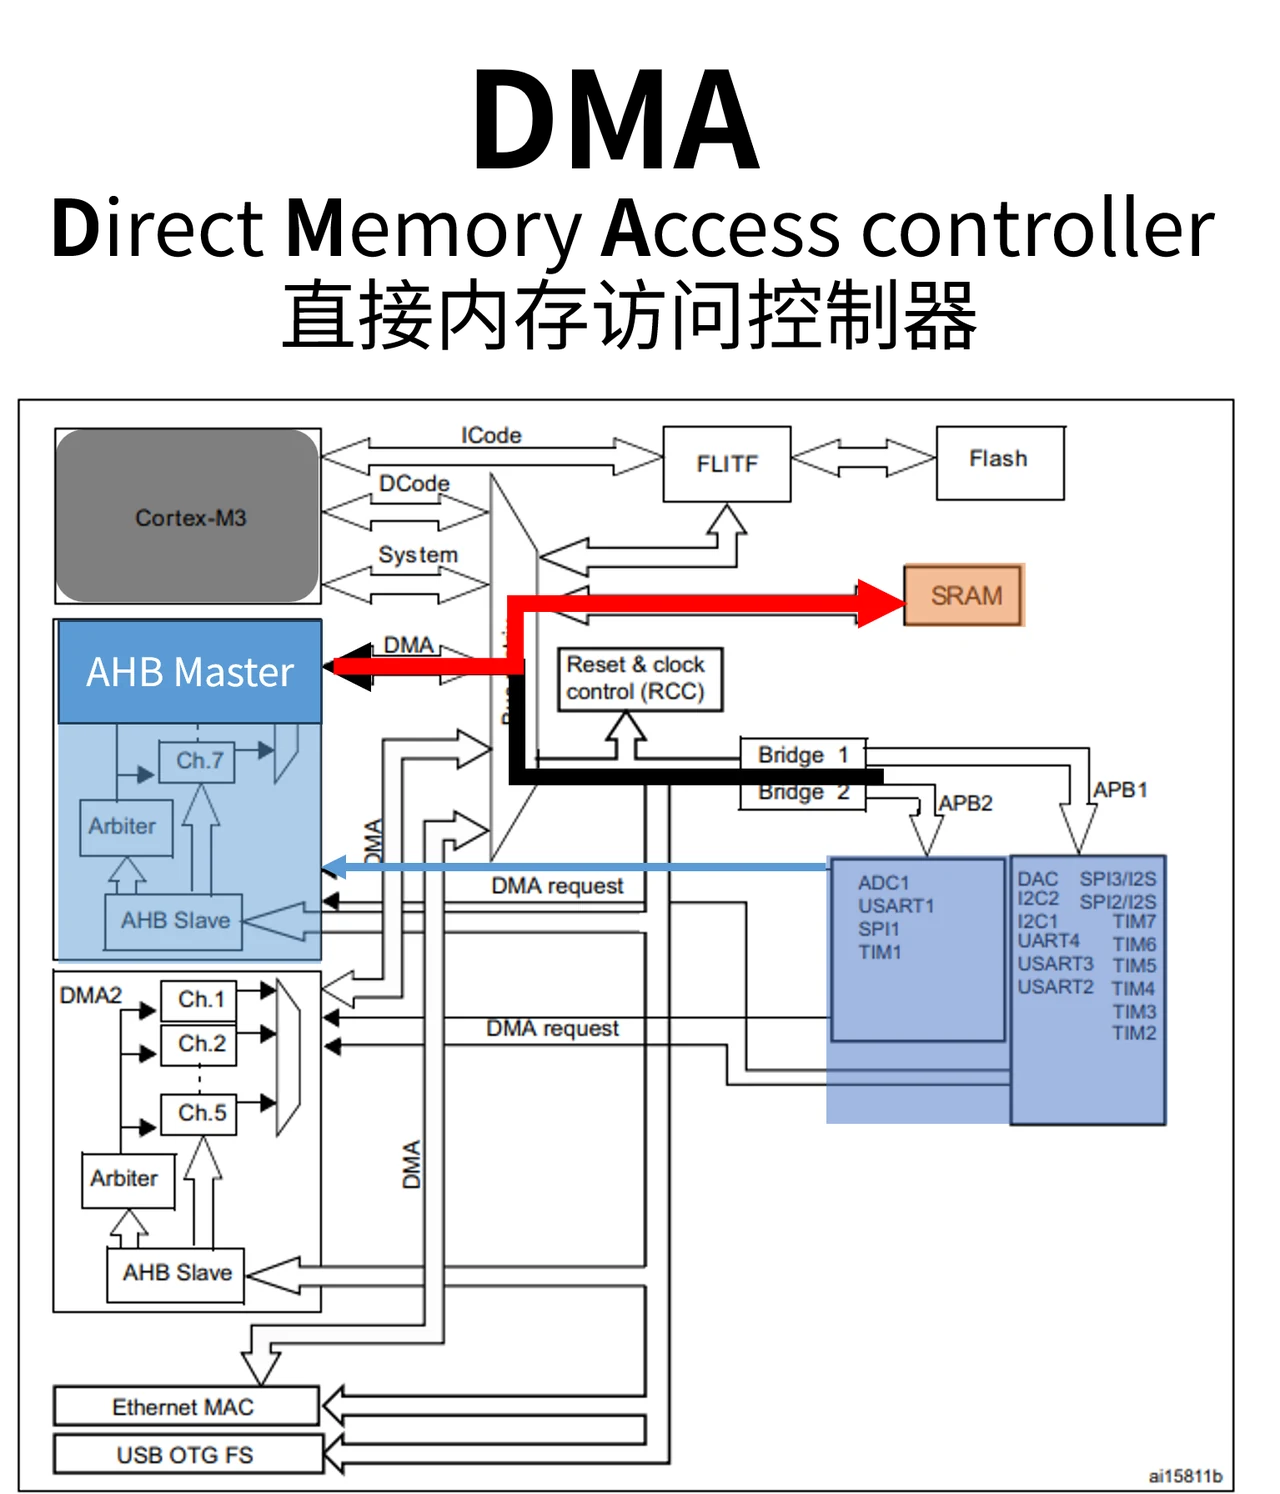
“不经过 CPU 搬运”并不等于完全不需要 CPU。配置、启动、状态处理与数据使用,仍需要程序协调。
2 搬运的来源与目标
| 方向 | 课程中的关联场景 |
|---|---|
| 外设到内存 | ADC 采集、串口接收 |
| 内存到外设 | 串口发送,或具备相应请求通路的输出外设 |
| 内存到内存 | 把一段数据复制到另一段内存 |
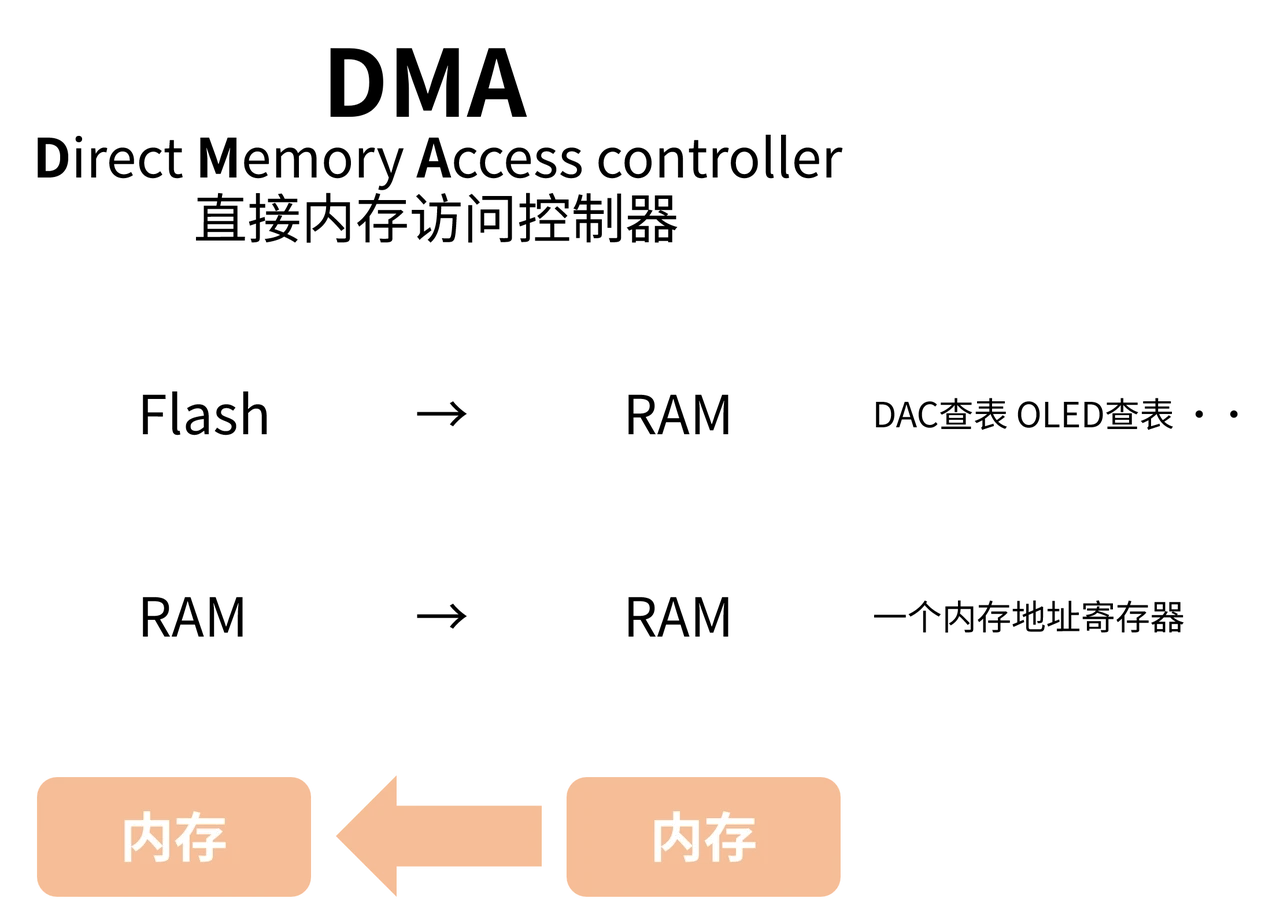
DMA 的请求连接和访问能力由具体芯片决定。不能只看数据方向,就认为任意两个外设都可以直接接起来。
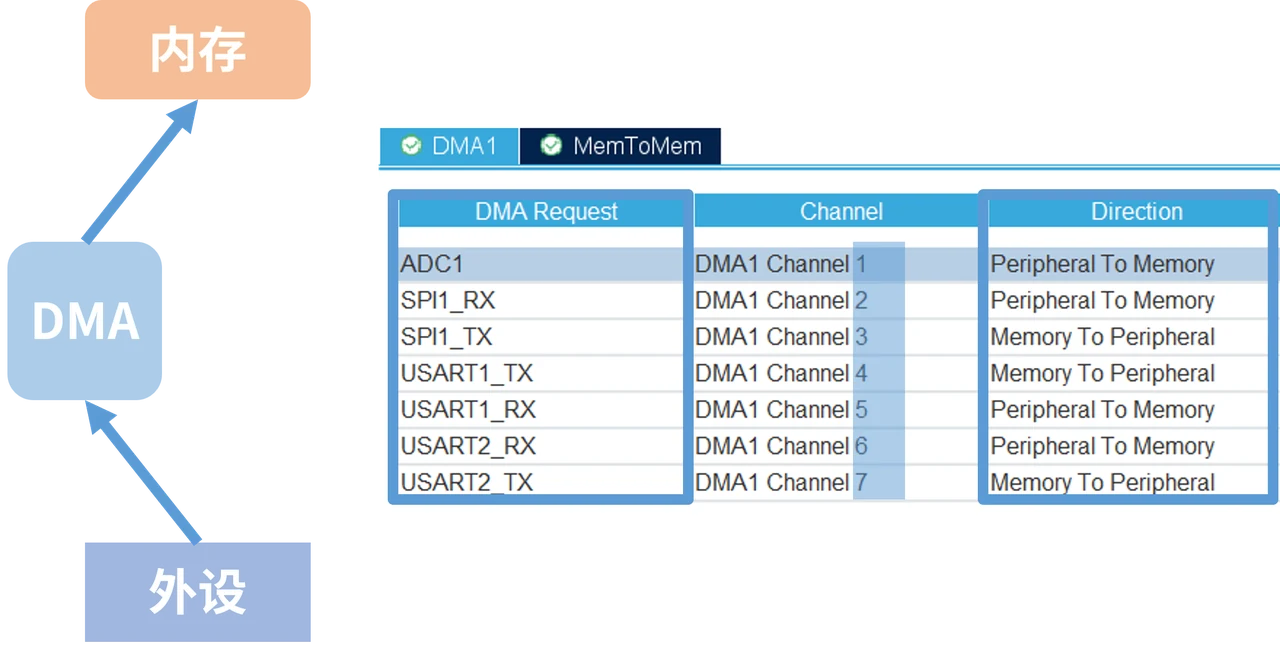
3 配置一个通道需要哪些信息
课程芯片的 DMA1 包含七个通道,外设请求与通道之间有固定映射。选择通道之后,还需要明确地址、数量和传输方式。
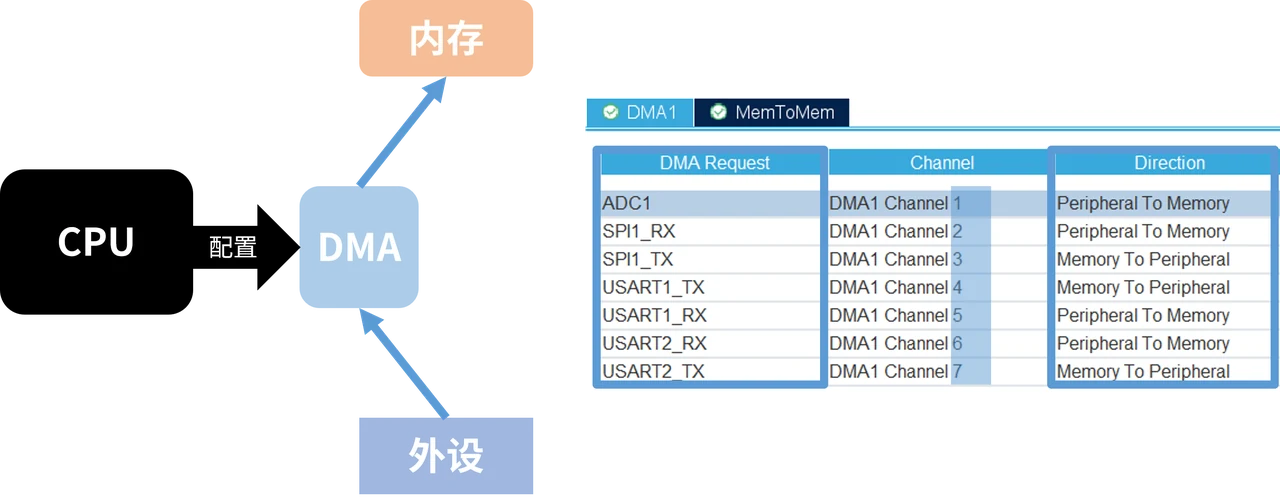
| 参数 | 要回答的问题 |
|---|---|
| 外设地址、内存地址 | 从哪里读取,向哪里写入 |
| 数据数量 | 一共传多少个数据项 |
| 传输位宽 | 每项按 8、16 还是 32 位访问 |
| 地址自增 | 每传一次,地址是否移到下一项 |
| 普通/循环模式 | 一轮完成后停止,还是重新开始 |
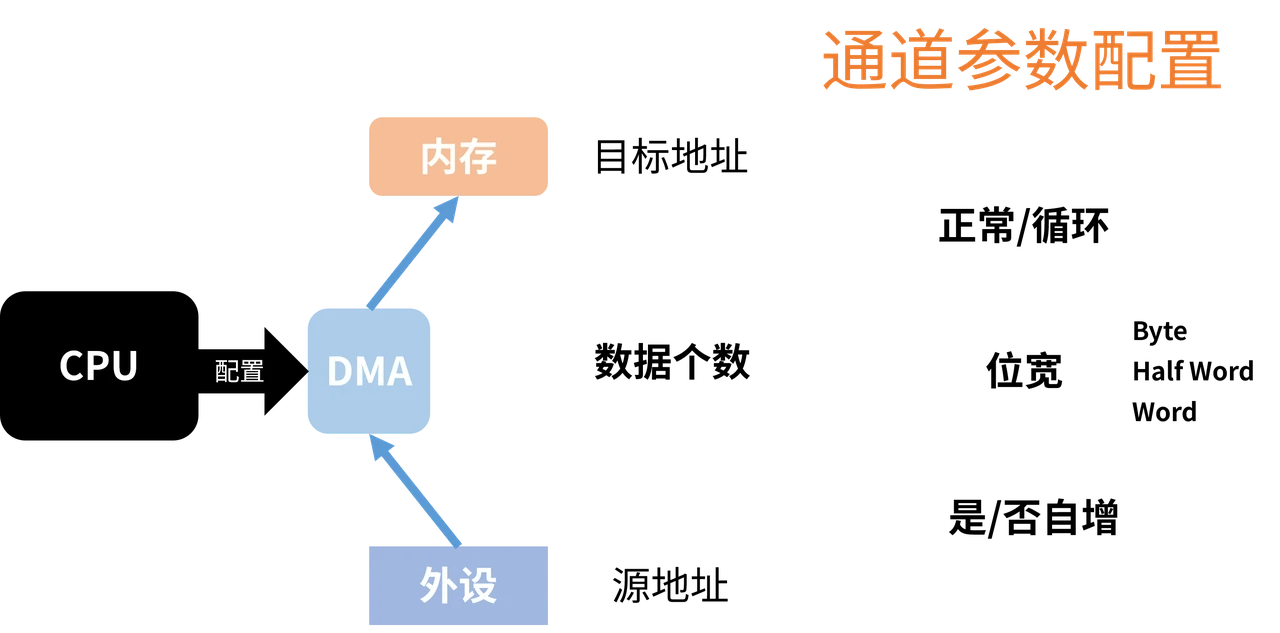
例如,连续读取同一个外设数据寄存器时,外设地址通常保持不变;把结果依次放入数组时,内存地址按相应步长递增。
固定的是请求映射,不是所有传输地址。 外设寄存器与内存缓冲区地址仍是配置的一部分。
4 多个请求怎样排队
DMA 通道有可配置的优先级。多个通道同时请求时,仲裁器先决定服务哪个;优先级相同时,还会按硬件规定的通道顺序处理。
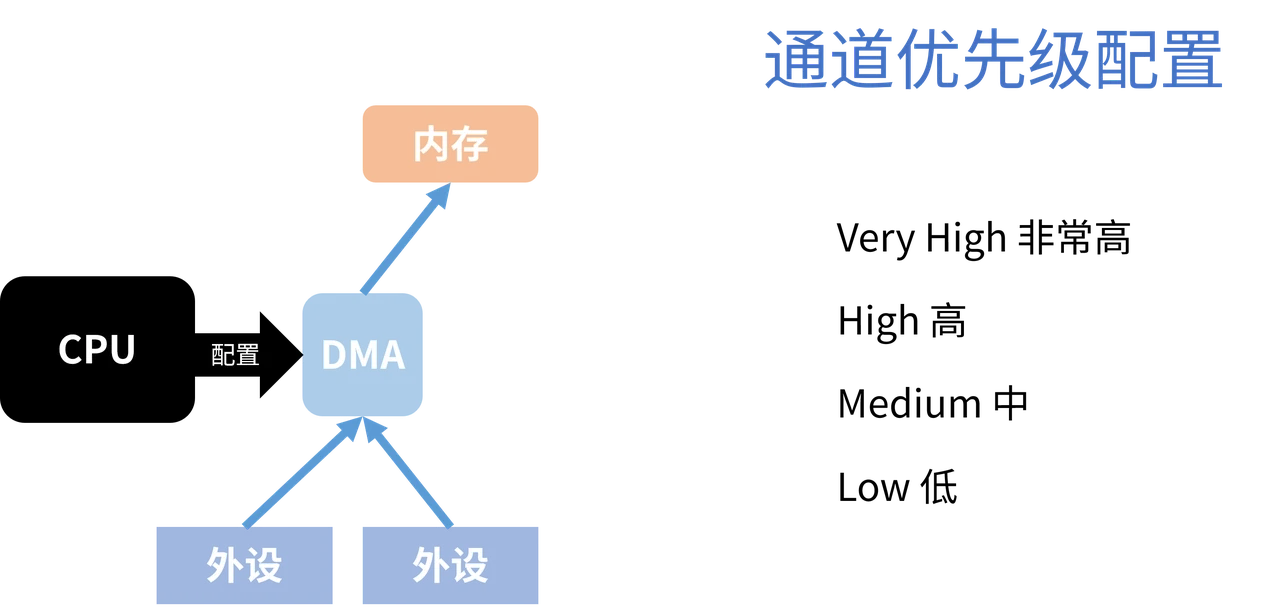
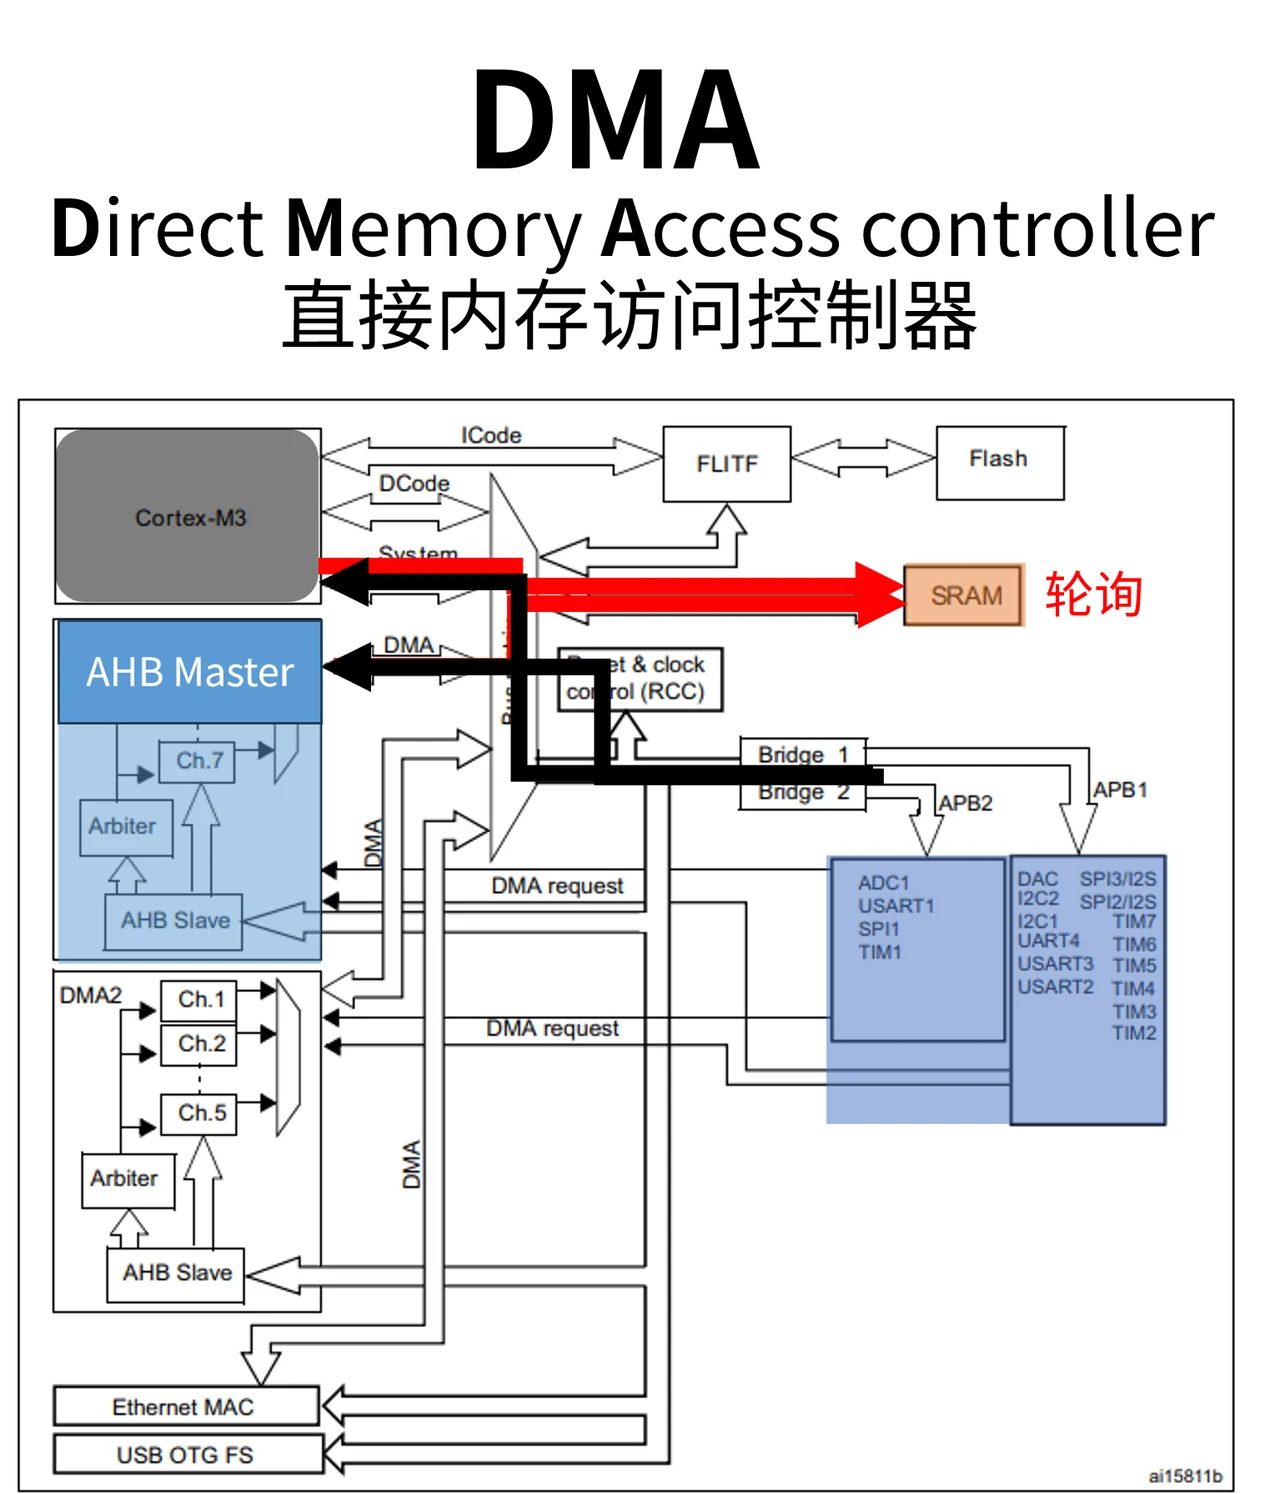
DMA 获得请求后,还要使用系统总线。如果 CPU 与 DMA 访问同一个目标,仍可能出现总线竞争。它与 DMA 通道之间的优先级是两个层面的问题。
5 单缓冲与双缓冲
单缓冲:一块区域接收一批数据
DMA 把指定数量的数据写满后,通知 CPU 处理。这个方式容易理解,但要考虑处理期间下一批数据怎么办。
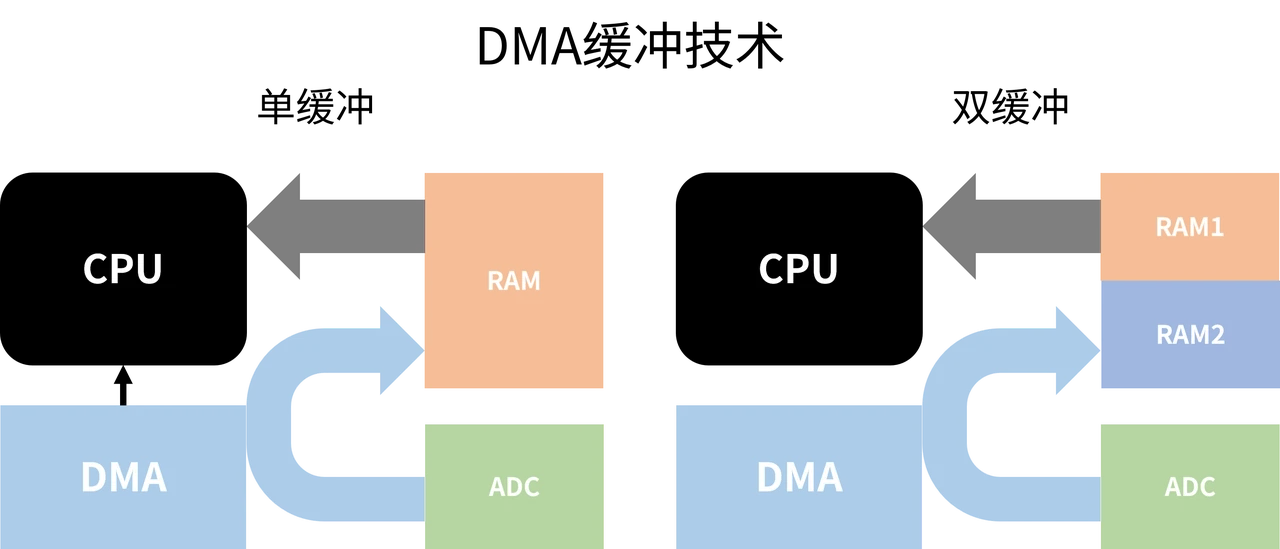
双缓冲:填充和处理交替进行
把数据安排在两个区域:DMA 写其中一块时,CPU 处理另一块;下一轮交换角色。这样可以减少双方互相等待的时间。
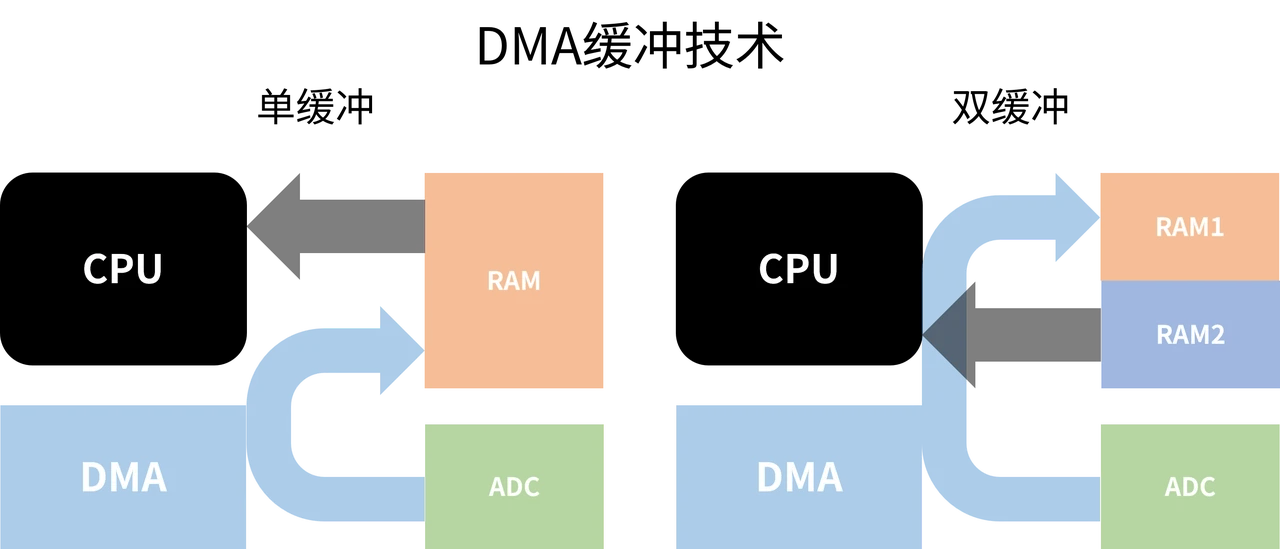
课程芯片没有每通道双内存地址的硬件双缓冲模式。可以采用的方式包括软件切换,以及把循环缓冲区分成两半,利用半传输与传输完成通知交替处理。
无论采用哪一种方式,都要把采样速度、缓冲区大小和处理耗时放在一起看。缓冲区只是争取时间,不能自动解决处理长期跟不上采集的问题。