综合实例:实现一个简单的神经网络
本篇目录:
在本节中,我们将介绍二维玩具神经网络的完整实现。我们将首先实现一个简单的线性分类器,然后将代码扩展到 2 层神经网络。正如我们将看到的,这个扩展非常简单,几乎不需要进行任何更改。
生成示例数据
让我们生成一个不容易线性分离的分类数据集。我们最喜欢的例子是螺旋数据集,它可以按如下方式生成:
N = 100 # number of points per class
D = 2 # dimensionality
K = 3 # number of classes
X = np.zeros((N*K,D)) # data matrix (each row = single example)
y = np.zeros(N*K, dtype='uint8') # class labels
for j in range(K):
  ix = range(N*j,N*(j+1))
  r = np.linspace(0.0,1,N) # radius
  t = np.linspace(j*4,(j+1)*4,N) + np.random.randn(N)*0.2 # theta
  X[ix] = np.c_[r*np.sin(t), r*np.cos(t)]
  y[ix] = j
# lets visualize the data:
plt.scatter(X[:, 0], X[:, 1], c=y, s=40, cmap=plt.cm.Spectral)
plt.show()
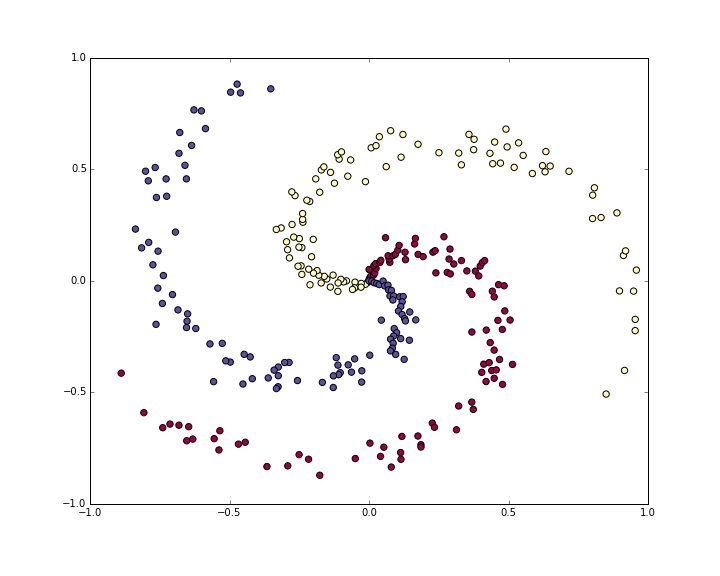
通常我们希望对数据集进行预处理,以便每个特征的均值和单位标准差为零,但在这种情况下,特征已经在 -1 到 1 的良好范围内,因此我们跳过此步骤。
训练 Softmax 线性分类器
初始化参数
首先让我们在此分类数据集上训练 Softmax 分类器。正如我们在前面几节中看到的,Softmax 分类器具有线性得分函数并使用交叉熵损失。线性分类器的参数由每个类别的权重矩阵 W 和偏置向量 b 组成。让我们首先将这些参数初始化为随机数:
# initialize parameters randomly
W = 0.01 * np.random.randn(D,K)
b = np.zeros((1,K))
回想一下,我们 D = 2 是维度,K = 3 是类数。
计算类别得分
由于这是一个线性分类器,我们可以非常简单地通过单个矩阵乘法并行计算所有类别得分:
# compute class scores for a linear classifier
scores = np.dot(X, W) + b
在这个例子中,我们有 300 个 2-D 点,因此在相乘之后,数组 scores 的大小将是 [300 x 3],其中每行给出与 3 个类别(蓝色、红色、黄色)相对应的类别得分。
计算损失
我们需要的第二个关键要素是损失函数,它是一个可微分的目标,可以通过计算的类别得分来量化我们的不满程度。直觉上,我们希望正确的类别比其他类别有更高的分数。在这种情况下,损失应该低,否则损失应该高。有很多方法可以量化这种直觉,但在这个例子中,我们使用与 Softmax 分类器相关的交叉熵损失。回想一下,如果 \\(f\\) 是单个示例的类别得分数组(例如,此处由 3 个数字组成的数组),则 Softmax 分类器将该示例的损失计算为:
$$ L_i = -\log\left(\frac{e^{f_{y_i}}}{ \sum_j e^{f_j} }\right) $$
Softmax 分类器将 \\(f\\) 中的每个元素视为对应类别的未归一化对数概率。先取指数得到未归一化概率,再归一化得到各类别概率。因此,对数内部的表达式就是正确类别的归一化概率,范围为 0 到 1。当正确类别的概率很小、接近 0 时,损失趋向正无穷;当其概率趋近 1 时,因为 \\(log(1) = 0\\),损失趋近 0。因此,正确类别概率较高时 \\(L_i\\) 较小,概率较低时则很大。
还记得完整的 Softmax 分类器损失被定义为训练示例和正则化的平均交叉熵损失:
$$ L = \underbrace{ \frac{1}{N} \sum_i L_i }_\text{data loss} + \underbrace{ \frac{1}{2} \lambda \sum_k\sum_l W_{k,l}^2 }_\text{regularization loss} \\\\ $$
给定我们上面计算的 scores 数组,我们可以计算损失。首先,获得概率的方法很简单:
num_examples = X.shape[0]
# get unnormalized probabilities
exp_scores = np.exp(scores)
# normalize them for each example
probs = exp_scores / np.sum(exp_scores, axis=1, keepdims=True)
我们现在有一个大小为 [300 x 3] 的数组 probs,其中每行现在包含类概率。特别是,由于我们已经将它们标准化,所以现在每一行的总和都为 1。我们现在可以查询每个示例中分配给正确类的对数概率:
correct_logprobs = -np.log(probs[range(num_examples),y])
数组 correct_logprobs 是一个一维数组,其中仅包含分配给每个示例的正确类别的概率。完整损失是这些对数概率和正则化损失的平均值:
# compute the loss: average cross-entropy loss and regularization
data_loss = np.sum(correct_logprobs)/num_examples
reg_loss = 0.5*reg*np.sum(W*W)
loss = data_loss + reg_loss
在此代码中,正则化强度 \\(\lambda\\) 存储在 reg 内。 0.5 乘以正则化的便利系数很快就会变得清晰。在开始时(使用随机参数)对其进行评估可能会给出 loss = 1.1,即 -np.log(1.0/3),因为初始随机权重较小,分配给所有类别的所有概率约为三分之一。我们现在希望使损失尽可能低,以 loss = 0 作为绝对下限。但损失越低,所有示例分配给正确类别的概率就越高。
通过反向传播计算解析梯度
我们有一种评估损失的方法,现在我们必须将其最小化。我们将通过梯度下降来做到这一点。也就是说,我们从随机参数开始(如上所示),并评估损失函数相对于参数的梯度,以便我们知道应该如何改变参数来减少损失。让我们引入中间变量 \\(p\\),它是(归一化)概率的向量。一个例子的损失是:
$$ p_k = \frac{e^{f_k}}{ \sum_j e^{f_j} } \hspace{1in} L_i =-\log\left(p_{y_i}\right) $$
接下来要弄清楚:怎样改变 \\(f\\) 中的得分,才能减小该样本对总目标贡献的损失 \\(L_i\\)。也就是说,需要推导梯度 \\( \partial L_i / \partial f_k \\)。损失 \\(L_i\\) 由 \\(p\\) 计算得到,而后者又依赖于 \\(f\\)。可以尝试自己使用链式法则推导;经过一系列约分和消去后,最终结果非常简单,而且具有直观的含义:
$$ \frac{\partial L_i }{ \partial f_k } = p_k - \mathbb{1}(y_i = k) $$
这个结果既简洁又直观。假设算出的概率为 p = [0.2, 0.3, 0.5],正确类别位于中间,其概率为 0.3。根据上述推导,损失对各类别得分的梯度为 df = [0.2, -0.7, 0.5]。回顾梯度的含义:增大得分向量 f 的第一个或最后一个元素,也就是提高错误类别的得分,会使损失增大,因为相应梯度为正数 +0.2 和 +0.5。提高错误类别得分是不利的,这与预期一致。相反,提高正确类别得分对损失的影响为负;梯度 −0.7 表明,提高该得分会降低损失 \\(L_i\\),也符合直觉。
所有这些都归结为以下代码。回想一下,probs 存储每个示例的所有类的概率(作为行)。为了获得分数的梯度(我们称之为 dscores),我们进行如下操作:
dscores = probs
dscores[range(num_examples),y] -= 1
dscores /= num_examples
最后,我们有了 scores = np.dot(X, W) + b,因此配备了 scores 上的梯度(存储在 dscores 中),我们现在可以反向传播到 W 和 b:
dW = np.dot(X.T, dscores)
db = np.sum(dscores, axis=0, keepdims=True)
dW += reg*W # don't forget the regularization gradient
我们看到我们已经通过矩阵乘法运算进行了反向传播,并且还添加了正则化的贡献。请注意,正则化梯度具有非常简单的形式 reg*W,因为我们使用常量 0.5 来表示其损失贡献(即 \\(\frac{d}{dw} ( \frac{1}{2} \lambda w^2) = \lambda w\\))。这是简化梯度表达式的常见便利技巧。
执行一次参数更新
现在我们已经评估了梯度,我们知道每个参数如何影响损失函数。我们现在将在负梯度方向上执行参数更新,以减少损失:
# perform a parameter update
W += -step_size * dW
b += -step_size * db
整合实现:训练 Softmax 分类器
将所有这些放在一起,以下是使用梯度下降训练 Softmax 分类器的完整代码:
#Train a Linear Classifier

# initialize parameters randomly
W = 0.01 * np.random.randn(D,K)
b = np.zeros((1,K))

# some hyperparameters
step_size = 1e-0
reg = 1e-3 # regularization strength

# gradient descent loop
num_examples = X.shape[0]
for i in range(200):

  # evaluate class scores, [N x K]
  scores = np.dot(X, W) + b

  # compute the class probabilities
  exp_scores = np.exp(scores)
  probs = exp_scores / np.sum(exp_scores, axis=1, keepdims=True) # [N x K]

  # compute the loss: average cross-entropy loss and regularization
  correct_logprobs = -np.log(probs[range(num_examples),y])
  data_loss = np.sum(correct_logprobs)/num_examples
  reg_loss = 0.5*reg*np.sum(W*W)
  loss = data_loss + reg_loss
  if i % 10 == 0:
    print "iteration %d: loss %f" % (i, loss)

  # compute the gradient on scores
  dscores = probs
  dscores[range(num_examples),y] -= 1
  dscores /= num_examples

  # backpropate the gradient to the parameters (W,b)
  dW = np.dot(X.T, dscores)
  db = np.sum(dscores, axis=0, keepdims=True)

  dW += reg*W # regularization gradient

  # perform a parameter update
  W += -step_size * dW
  b += -step_size * db
运行此命令会打印输出:
iteration 0: loss 1.096956
iteration 10: loss 0.917265
iteration 20: loss 0.851503
iteration 30: loss 0.822336
iteration 40: loss 0.807586
iteration 50: loss 0.799448
iteration 60: loss 0.794681
iteration 70: loss 0.791764
iteration 80: loss 0.789920
iteration 90: loss 0.788726
iteration 100: loss 0.787938
iteration 110: loss 0.787409
iteration 120: loss 0.787049
iteration 130: loss 0.786803
iteration 140: loss 0.786633
iteration 150: loss 0.786514
iteration 160: loss 0.786431
iteration 170: loss 0.786373
iteration 180: loss 0.786331
iteration 190: loss 0.786302
我们发现,经过大约 190 次迭代后,我们已经收敛到某个值。我们可以评估训练集的准确性:
# evaluate training set accuracy
scores = np.dot(X, W) + b
predicted_class = np.argmax(scores, axis=1)
print 'training accuracy: %.2f' % (np.mean(predicted_class == y))
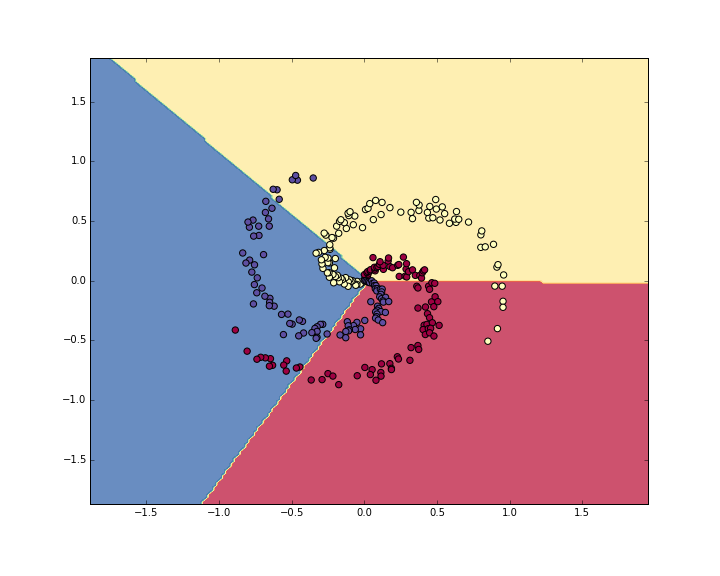
这将打印 49%。一点也不好,但考虑到数据集的构造不是线性可分的,这也不足为奇。我们还可以绘制学习到的决策边界:
训练神经网络
显然,线性分类器不足以处理该数据集,我们希望使用神经网络。对于这个示例数据来说,一个额外的隐藏层就足够了。我们现在需要两组权重和偏置(对于第一层和第二层):
# initialize parameters randomly
h = 100 # size of hidden layer
W = 0.01 * np.random.randn(D,h)
b = np.zeros((1,h))
W2 = 0.01 * np.random.randn(h,K)
b2 = np.zeros((1,K))
计算分数的前向传播现在改变形式:
# evaluate class scores with a 2-layer Neural Network
hidden_layer = np.maximum(0, np.dot(X, W) + b) # note, ReLU activation
scores = np.dot(hidden_layer, W2) + b2
请注意,与之前相比唯一的变化是增加了一行代码,我们首先计算隐藏层表示,然后计算基于该隐藏层的分数。至关重要的是,我们还添加了非线性,在本例中是简单的 ReLU,它将隐藏层上的激活阈值设置为零。
其余部分不变:仍按之前的方法根据得分计算损失,并得到损失对得分的梯度 dscores。但把梯度继续传回模型参数时,计算形式有所变化。先对神经网络第二层做反向传播,其代码与 Softmax 分类器相同,只是把原始数据 X 替换为变量 hidden_layer:
# backpropate the gradient to the parameters
# first backprop into parameters W2 and b2
dW2 = np.dot(hidden_layer.T, dscores)
db2 = np.sum(dscores, axis=0, keepdims=True)
然而,与之前不同的是,我们还没有完成,因为 hidden_layer 本身就是其他参数和数据的函数!我们需要通过这个变量继续反向传播。其梯度可以计算为:
dhidden = np.dot(dscores, W2.T)
现在我们有了隐藏层输出的梯度。接下来,我们必须反向传播 ReLU 非线性。事实证明这很容易,因为反向传播过程中的 ReLU 实际上是一个开关。由于\\(r = max(0, x)\\),我们有\\(\frac{dr}{dx} = 1(x > 0) \\)。结合链式法则,我们看到,如果 ReLU 单元的输入大于 0,则它会让梯度保持不变地通过,但如果在前向传播过程中其输入小于 0,则阻断梯度传播。因此,我们可以简单地反向传播 ReLU:
# backprop the ReLU non-linearity
dhidden[hidden_layer <= 0] = 0
现在我们终于继续第一层权重和偏置:
# finally into W,b
dW = np.dot(X.T, dhidden)
db = np.sum(dhidden, axis=0, keepdims=True)
我们完成了!我们有梯度 dW,db,dW2,db2 并且可以执行参数更新。其他一切保持不变。完整的代码看起来非常相似:
# initialize parameters randomly
h = 100 # size of hidden layer
W = 0.01 * np.random.randn(D,h)
b = np.zeros((1,h))
W2 = 0.01 * np.random.randn(h,K)
b2 = np.zeros((1,K))

# some hyperparameters
step_size = 1e-0
reg = 1e-3 # regularization strength

# gradient descent loop
num_examples = X.shape[0]
for i in range(10000):

  # evaluate class scores, [N x K]
  hidden_layer = np.maximum(0, np.dot(X, W) + b) # note, ReLU activation
  scores = np.dot(hidden_layer, W2) + b2

  # compute the class probabilities
  exp_scores = np.exp(scores)
  probs = exp_scores / np.sum(exp_scores, axis=1, keepdims=True) # [N x K]

  # compute the loss: average cross-entropy loss and regularization
  correct_logprobs = -np.log(probs[range(num_examples),y])
  data_loss = np.sum(correct_logprobs)/num_examples
  reg_loss = 0.5*reg*np.sum(W*W) + 0.5*reg*np.sum(W2*W2)
  loss = data_loss + reg_loss
  if i % 1000 == 0:
    print "iteration %d: loss %f" % (i, loss)

  # compute the gradient on scores
  dscores = probs
  dscores[range(num_examples),y] -= 1
  dscores /= num_examples

  # backpropate the gradient to the parameters
  # first backprop into parameters W2 and b2
  dW2 = np.dot(hidden_layer.T, dscores)
  db2 = np.sum(dscores, axis=0, keepdims=True)
  # next backprop into hidden layer
  dhidden = np.dot(dscores, W2.T)
  # backprop the ReLU non-linearity
  dhidden[hidden_layer <= 0] = 0
  # finally into W,b
  dW = np.dot(X.T, dhidden)
  db = np.sum(dhidden, axis=0, keepdims=True)

  # add regularization gradient contribution
  dW2 += reg * W2
  dW += reg * W

  # perform a parameter update
  W += -step_size * dW
  b += -step_size * db
  W2 += -step_size * dW2
  b2 += -step_size * db2
这打印:
iteration 0: loss 1.098744
iteration 1000: loss 0.294946
iteration 2000: loss 0.259301
iteration 3000: loss 0.248310
iteration 4000: loss 0.246170
iteration 5000: loss 0.245649
iteration 6000: loss 0.245491
iteration 7000: loss 0.245400
iteration 8000: loss 0.245335
iteration 9000: loss 0.245292
现在的训练准确率是:
# evaluate training set accuracy
hidden_layer = np.maximum(0, np.dot(X, W) + b)
scores = np.dot(hidden_layer, W2) + b2
predicted_class = np.argmax(scores, axis=1)
print 'training accuracy: %.2f' % (np.mean(predicted_class == y))
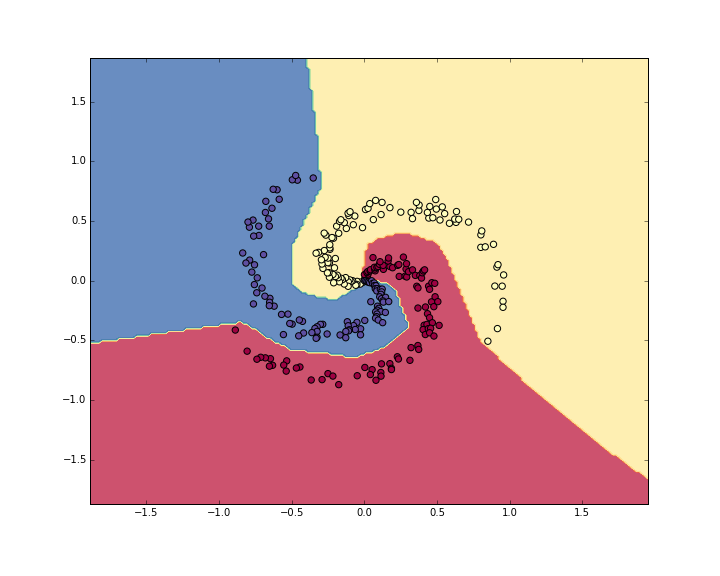
打印 98%!。我们还可以可视化决策边界:
小结
我们使用了一个玩具 2D 数据集,并训练了线性网络和 2 层神经网络。我们看到从线性分类器到神经网络的变化只涉及很少的代码变化。得分函数改变了它的形式(1行代码差异),反向传播改变了它的形式(我们必须通过隐藏层到网络的第一层再执行一轮反向传播)。