图像分类:数据驱动方法、k 近邻与数据集划分
这是一个介绍性讲座,旨在向计算机视觉领域之外的人员介绍图像分类问题和数据驱动方法。目录:
图像分类
动机。在本节中,我们将介绍图像分类问题,该问题是从一组固定类别中为输入图像分配一个标签的任务。这是计算机视觉的核心问题之一,尽管它很简单,但具有多种实际应用。此外,正如我们稍后将在课程中看到的,许多其他看似不同的计算机视觉任务(例如目标检测、分割)可以简化为图像分类。
示例。例如,在下图中,图像分类模型采用单个图像并将概率分配给 4 个标签,{猫、狗、帽子、杯子}。如图所示,请记住,对于计算机来说,图像表示为一个大型的 3 维数字数组。在此示例中,猫图像宽 248 像素,高 400 像素,具有红、绿、蓝(简称 RGB)三个颜色通道。因此,该图像由 248 x 400 x 3 个数字组成,即总共 297,600 个数字。每个数字都是一个范围从 0(黑色)到 255(白色)的整数。我们的任务是将这四分之一百万个数字转换为单个标签,例如“cat”。
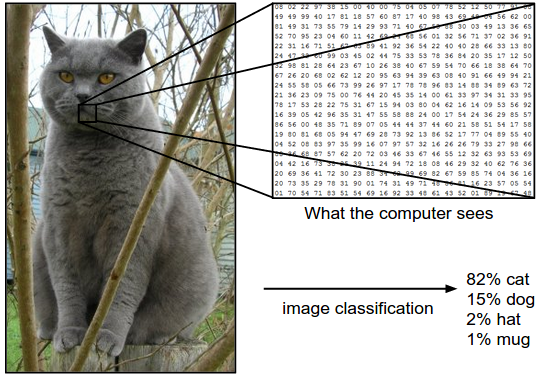
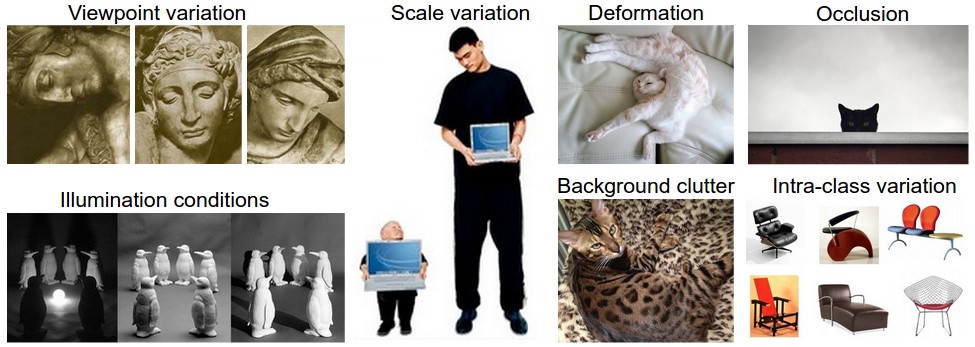
挑战。由于识别视觉概念(例如猫)的任务对于人类来说相对简单,因此值得从计算机视觉算法的角度考虑所涉及的挑战。正如我们在下面列出的(不详尽的)挑战列表,请记住图像的原始表示形式为亮度值的 3D 数组:
- 观点变化。对象的单个实例可以通过多种方式相对于相机定向。
- 规模变化。视觉类通常表现出大小的变化(现实世界中的大小,而不仅仅是图像中的大小)。
- 变形。许多感兴趣的物体都不是刚体,并且可以以极端的方式变形。
- 遮挡。可以遮挡感兴趣的对象。有时,只有对象的一小部分(小至几个像素)可见。
- 照明条件。照明对像素级的影响是巨大的。
- 背景混乱。感兴趣的对象可能融入其环境中,从而难以识别。
- 类内差异。感兴趣的类别通常可以相对广泛,例如椅子。这些物体有许多不同类型,每种都有自己的外观。
好的图像分类模型应对上述因素的各种组合变化保持不变性,同时仍能敏锐地区分不同类别之间的差异。
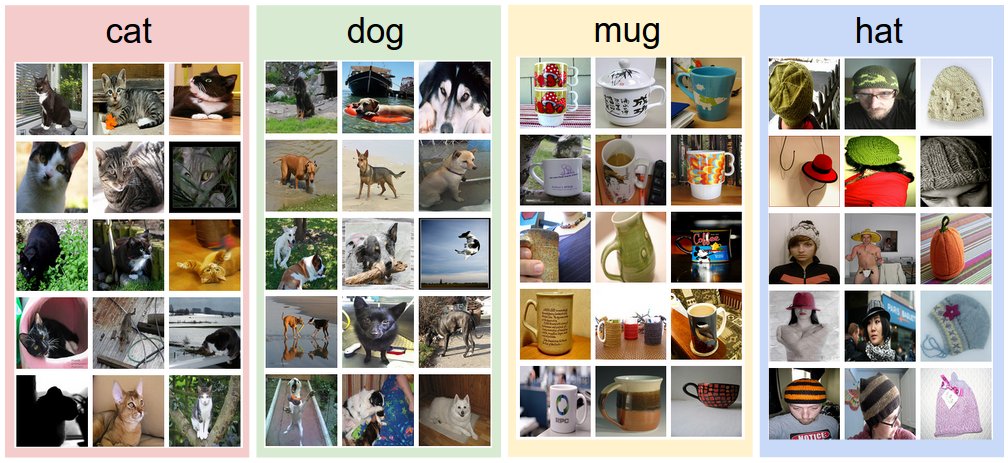
数据驱动方法。我们如何编写一种可以将图像分类为不同类别的算法?与编写用于对数字列表进行排序等的算法不同,如何编写用于识别图像中的猫的算法并不明显。因此,我们不会尝试直接在代码中指定每个感兴趣的类别的外观,而是采用的方法与您对孩子采取的方法没有什么不同:我们将为计算机提供每个类别的许多示例,然后开发学习算法来查看这些示例并了解每个类别的视觉外观。这种方法被称为数据驱动方法,因为它依赖于首先积累标记图像的训练数据集。以下是此类数据集的示例:
图像分类流程。我们已经看到,图像分类中的任务是获取代表单个图像的像素数组并为其分配标签。我们完整的管道可以形式化如下:
- 输入:我们的输入由一组 N 个图像组成,每个图像都标有 K 个不同类别之一。我们将此数据称为训练集。
- 学习:利用训练集学习各个类别的视觉特征。这一步称为训练分类器,也称学习模型。
- 评估:最后,让分类器预测一组从未见过的新图像的标签,以此评价分类效果。我们将预测标签与这些图像的真实标签进行比较,希望尽可能多的预测与正确答案一致;这些正确答案称为真实标签(ground truth)。
最近邻分类器
作为我们的第一种方法,我们将开发所谓的最近邻分类器。该分类器与卷积神经网络无关,在实践中很少使用,但它可以让我们了解图像分类问题的基本方法。
图像分类数据集示例:CIFAR-10。CIFAR-10 数据集是一种流行的用于实验的图像分类数据集。该数据集由 60,000 张高和宽均为 32 像素的小图像组成。每个图像都标有 10 个类别之一(例如“飞机、汽车、鸟类等”)。这 60,000 张图像被划分为 50,000 张图像的训练集和 10,000 张图像的测试集。在下图中,您可以看到 10 个类别中每一类别的 10 张随机示例图像:
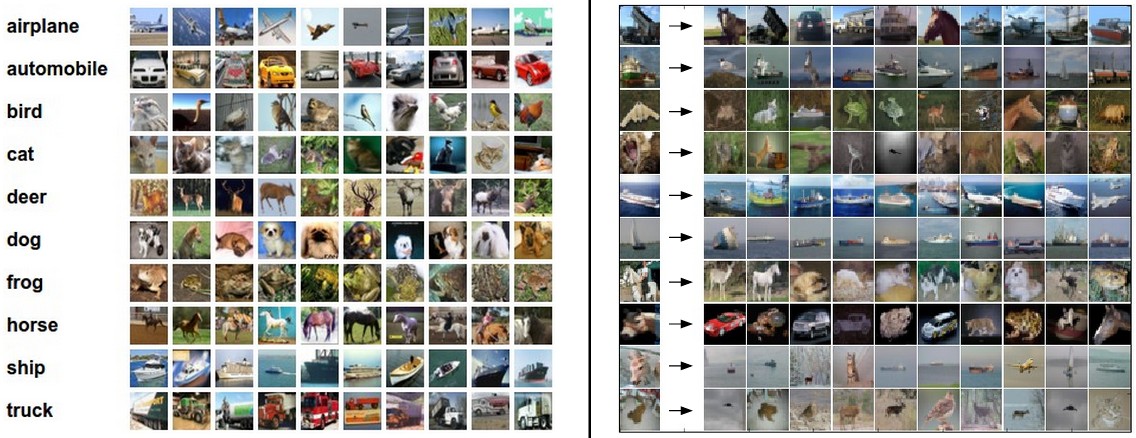
现在假设我们获得了包含 50,000 张图像的 CIFAR-10 训练集(每个标签对应 5,000 张图像),并且我们希望标记剩余的 10,000 张图像。最近邻分类器将获取测试图像,将其与每一个训练图像进行比较,并预测最接近的训练图像的标签。在上图中和右图中,您可以看到 10 个示例测试图像的此类过程的示例结果。请注意,在 10 个示例中,只有大约 3 个会检索到同一类别的图像,而在其他 7 个示例中,情况并非如此。例如,在第 8 行中,距离马头最近的训练图像是一辆红色汽车,大概是由于强烈的黑色背景。因此,在这种情况下,马的图像会被错误地标记为汽车。
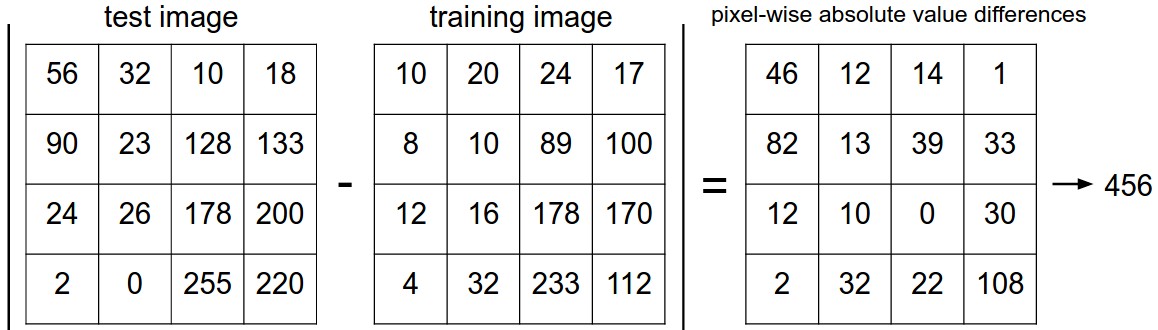
您可能已经注意到,我们没有具体说明如何比较两个图像,在本例中只是两个 32 x 32 x 3 的块。最简单的可能性之一是逐像素比较图像并将所有差异相加。换句话说,给定两个图像并将它们表示为向量 \\( I_1, I_2 \\) ,比较它们的合理选择可能是 L1 距离:
$$ d_1 (I_1, I_2) = \sum_{p} \left| I^p_1 - I^p_2 \right| $$
其中对所有像素进行求和。这是可视化的过程:
让我们看看如何在代码中实现分类器。首先,我们将 CIFAR-10 数据作为 4 个数组加载到内存中:训练数据/标签和测试数据/标签。在下面的代码中,Xtr(大小为 50,000 x 32 x 32 x 3)保存训练集中的所有图像,相应的一维数组 Ytr(长度为 50,000)保存训练标签(从 0 到 9):
Xtr, Ytr, Xte, Yte = load_CIFAR10('data/cifar10/') # a magic function we provide
# flatten out all images to be one-dimensional
Xtr_rows = Xtr.reshape(Xtr.shape[0], 32 * 32 * 3) # Xtr_rows becomes 50000 x 3072
Xte_rows = Xte.reshape(Xte.shape[0], 32 * 32 * 3) # Xte_rows becomes 10000 x 3072
现在我们已经将所有图像拉伸为行,下面是我们如何训练和评估分类器:
nn = NearestNeighbor() # create a Nearest Neighbor classifier class
nn.train(Xtr_rows, Ytr) # train the classifier on the training images and labels
Yte_predict = nn.predict(Xte_rows) # predict labels on the test images
# and now print the classification accuracy, which is the average number
# of examples that are correctly predicted (i.e. label matches)
print 'accuracy: %f' % ( np.mean(Yte_predict == Yte) )
请注意,作为评估标准,通常使用准确率,它衡量预测正确的比例。请注意,我们将构建的所有分类器都满足这一通用 API:它们具有 train(X,y) 函数,该函数获取要学习的数据和标签。在内部,该类应该构建某种标签模型以及如何从数据中预测它们。然后是 predict(X) 函数,它获取新数据并预测标签。当然,我们忽略了核心内容——实际的分类器本身。下面是一个简单的最近邻分类器的实现,其 L1 距离满足此模板:
import numpy as np

class NearestNeighbor(object):
  def __init__(self):
    pass

  def train(self, X, y):
    """ X is N x D where each row is an example. Y is 1-dimension of size N """
    # the nearest neighbor classifier simply remembers all the training data
    self.Xtr = X
    self.ytr = y

  def predict(self, X):
    """ X is N x D where each row is an example we wish to predict label for """
    num_test = X.shape[0]
    # lets make sure that the output type matches the input type
    Ypred = np.zeros(num_test, dtype = self.ytr.dtype)

    # loop over all test rows
    for i in range(num_test):
      # find the nearest training image to the i'th test image
      # using the L1 distance (sum of absolute value differences)
      distances = np.sum(np.abs(self.Xtr - X[i,:]), axis = 1)
      min_index = np.argmin(distances) # get the index with smallest distance
      Ypred[i] = self.ytr[min_index] # predict the label of the nearest example

    return Ypred
如果您运行此代码,您会发现此分类器在 CIFAR-10 上仅达到 38.6%。这比随机猜测(由于有 10 个类别,准确率只有 10%)更令人印象深刻,但远不及人类表现(估计约为 94%),也远不及达到约 95% 的最先进的卷积神经网络,与人类准确率相当(请参阅最近 Kaggle 竞赛的排行榜) CIFAR-10)。
距离的选择。 还有许多其他计算向量之间距离的方法。另一个常见的选择可能是使用 L2 距离,它具有计算两个向量之间的欧几里德距离的几何解释。距离采用以下形式:
$$ d_2 (I_1, I_2) = \sqrt{\sum_{p} \left( I^p_1 - I^p_2 \right)^2} $$
换句话说,我们将像以前一样计算像素差异,但这次我们将它们全部平方,将它们相加,最后取平方根。在 numpy 中,使用上面的代码我们只需要替换一行代码。计算距离的行:
distances = np.sqrt(np.sum(np.square(self.Xtr - X[i,:]), axis = 1))
请注意,我在上面包含了 np.sqrt 调用,但在实际的最近邻应用程序中,我们可以省略平方根运算,因为平方根是一个单调函数。也就是说,它缩放了距离的绝对大小,但保留了顺序,因此有或没有它的最近邻是相同的。如果您使用此距离在 CIFAR-10 上运行最近邻分类器,您将获得 35.4% 准确率(略低于我们的 L1 距离结果)。
L1 与 L2:这两种距离度量的差别值得注意。比较两个向量时,L2 距离比 L1 距离对个别分量上的较大差异更敏感。换句话说,与一个很大的差异相比,L2 距离更倾向于接受多个中等大小的差异。L1 和 L2 距离,也就是两幅图像之差的 L1/L2 范数,是 p 范数最常用的两个特例。
k 近邻分类器
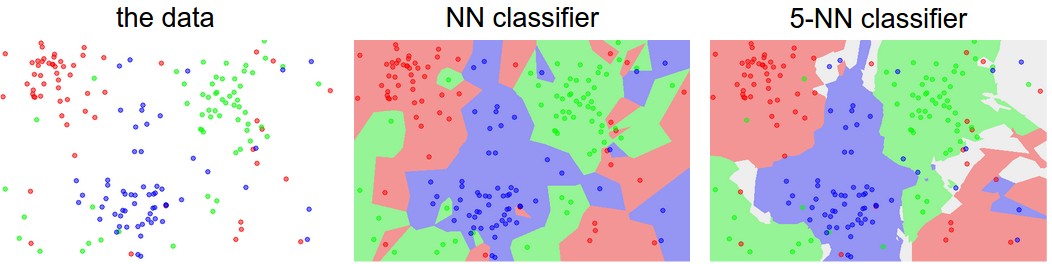
您可能已经注意到,当我们希望进行预测时,仅使用最近图像的标签是很奇怪的。事实上,几乎总是这样,通过使用所谓的k 近邻分类器可以做得更好。这个想法非常简单:我们不是在训练集中寻找单个最接近的图像,而是找到最接近的 k 个图像,并让它们对测试图像的标签进行投票。特别是,当k = 1时,我们恢复最近邻分类器。直观上,较高的 k 值具有平滑效果,使分类器更能抵抗异常值:
在实践中,您几乎总是想要使用 k 近邻。但是您应该使用什么值 k 呢?我们接下来讨论这个问题。
使用验证集调节超参数
k 最近邻分类器需要设置 k。但什么数字效果最好呢?此外,我们看到可以使用许多不同的距离函数:L1 范数、L2 范数,还有许多其他选择我们甚至没有考虑(例如点积)。这些选择称为超参数,它们在许多从数据中学习的机器学习算法的设计中经常出现。人们应该选择什么值/设置通常并不明显。
您可能会建议我们应该尝试许多不同的值,看看哪种最有效。这是一个好主意,这确实是我们要做的,但必须非常小心地做。特别是,我们不能将测试集用于调整超参数。每当您设计机器学习算法时,您都应该将测试集视为一种非常宝贵的资源,理想情况下永远不要触及它,直到最后一次。否则,真正的危险是,您可能会调整超参数以使其在测试集上运行良好,但如果要部署模型,您可能会发现性能显着下降。在实践中,我们会说您对测试集过拟合。另一种看待它的方式是,如果您在测试集上调整超参数,那么您实际上是在使用测试集作为训练集,因此您在测试集上实现的性能相对于您在部署模型时实际观察到的结果来说将过于乐观。但是,如果您在最后仅使用测试集一次,它仍然是衡量分类器的泛化的良好代理(我们将在课程后面看到更多关于泛化的讨论)。
最后仅对测试集进行一次评估。
幸运的是,有一种正确的方法来调整超参数,并且它根本不接触测试集。我们的想法是将我们的训练集分成两部分:一个稍小的训练集,以及我们所说的验证集。以 CIFAR-10 为例,我们可以使用 49,000 个训练图像进行训练,并留出 1,000 个用于验证。该验证集本质上用作假测试集来调整超参数。
以下是 CIFAR-10 的情况:
# assume we have Xtr_rows, Ytr, Xte_rows, Yte as before
# recall Xtr_rows is 50,000 x 3072 matrix
Xval_rows = Xtr_rows[:1000, :] # take first 1000 for validation
Yval = Ytr[:1000]
Xtr_rows = Xtr_rows[1000:, :] # keep last 49,000 for train
Ytr = Ytr[1000:]

# find hyperparameters that work best on the validation set
validation_accuracies = []
for k in [1, 3, 5, 10, 20, 50, 100]:

  # use a particular value of k and evaluation on validation data
  nn = NearestNeighbor()
  nn.train(Xtr_rows, Ytr)
  # here we assume a modified NearestNeighbor class that can take a k as input
  Yval_predict = nn.predict(Xval_rows, k = k)
  acc = np.mean(Yval_predict == Yval)
  print 'accuracy: %f' % (acc,)

  # keep track of what works on the validation set
  validation_accuracies.append((k, acc))
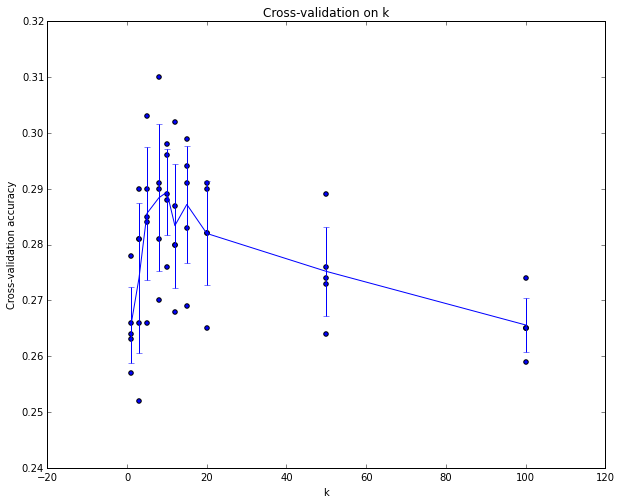
在此过程结束时,我们可以绘制一个图表来显示哪些 k 值效果最好。然后我们将坚持使用这个值并在实际测试集上评估一次。
将您的训练集分为训练集和验证集。使用验证集来调整所有超参数。最后在测试集上运行一次并报告性能。
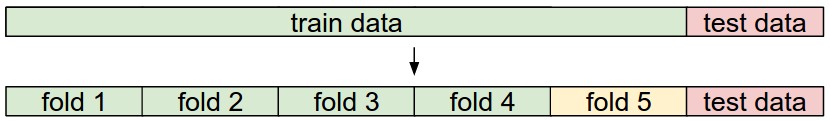
交叉验证。 如果训练数据(因此也包括验证数据)的大小可能很小,人们有时会使用一种更复杂的技术进行超参数调节,称为交叉验证。使用我们之前的示例,其想法是,您不必任意选择前 1000 个数据点作为验证集和其余训练集,而是可以通过迭代不同的验证集并对这些验证集的性能进行平均,从而更好地、噪声更少地估计 k 的某个值的工作效果。例如,在5折交叉验证中,我们将训练数据分成5等份,使用其中4个用于训练,1个用于验证。然后,我们将迭代哪个折是验证折,评估性能,最后对不同折的性能进行平均。
实践。在实践中,人们更喜欢避免交叉验证,而倾向于进行单个验证分割,因为交叉验证的计算代价可能很高。人们倾向于使用 50%-90% 的训练数据进行训练,其余的进行验证。然而,这取决于多种因素:例如,如果超参数的数量很大,您可能更喜欢使用更大的验证分割。如果验证集中的示例数量很少(可能只有几百个左右),那么使用交叉验证会更安全。在实践中,您可以看到的典型折次数是 3 折、5 折或 10 折交叉验证。
最近邻分类器的优点和缺点。
最近邻分类器的一些优点和缺点值得考虑。显然,它的一个优点是它非常容易实现和理解。此外,分类器不需要时间进行训练,因为所需要做的只是存储并可能索引训练数据。然而,我们在测试时支付计算代价,因为对测试示例进行分类需要与每个训练示例进行比较。这是倒退的,因为在实践中我们通常更关心测试时间效率而不是训练时间效率。事实上,我们稍后将在本课程中开发的深度神经网络将这种权衡转移到另一个极端:训练它们非常昂贵,但一旦训练完成,对新的测试示例进行分类就非常便宜。这种操作模式在实践中更可取。
顺便说一句,最近邻分类器的计算复杂性是一个活跃的研究领域,并且存在一些可以加速数据集中最近邻查找的近似最近邻 (ANN) 算法和库(例如FLANN)。这些算法允许人们在检索期间权衡最近邻检索的正确性与其空间/时间复杂度,并且通常依赖于涉及构建 kdtree 或运行 k-means 算法的预处理/索引阶段。
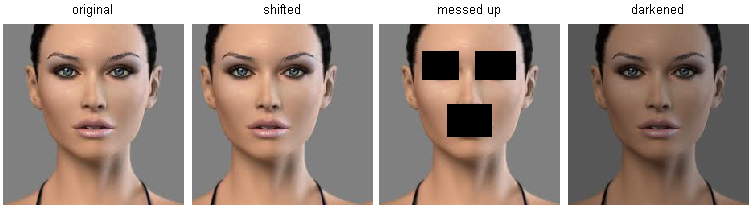
在某些设置中,最近邻分类器有时可能是一个不错的选择(特别是如果数据是低维的),但它很少适合在实际图像分类设置中使用。一个问题是图像是高维对象(即它们通常包含许多像素),并且高维空间上的距离可能非常违反直觉。下图说明了我们上面开发的基于像素的 L2 相似度与感知相似度有很大不同:
这是另一种可视化效果,可以让您相信使用像素差异来比较图像是不够的。我们可以使用一种名为 t-SNE 的可视化技术来获取 CIFAR-10 图像并将它们嵌入二维中,以便最好地保留它们的(局部)成对距离。在此可视化中,根据我们上面开发的 L2 像素距离,附近显示的图像被认为非常接近:
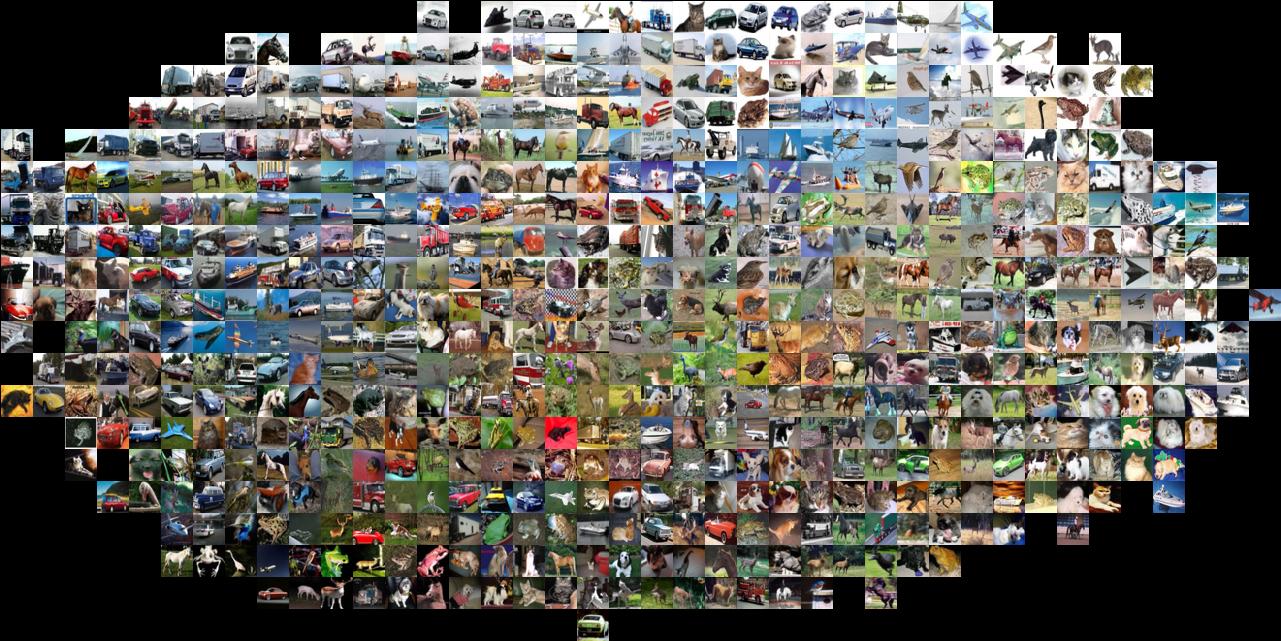
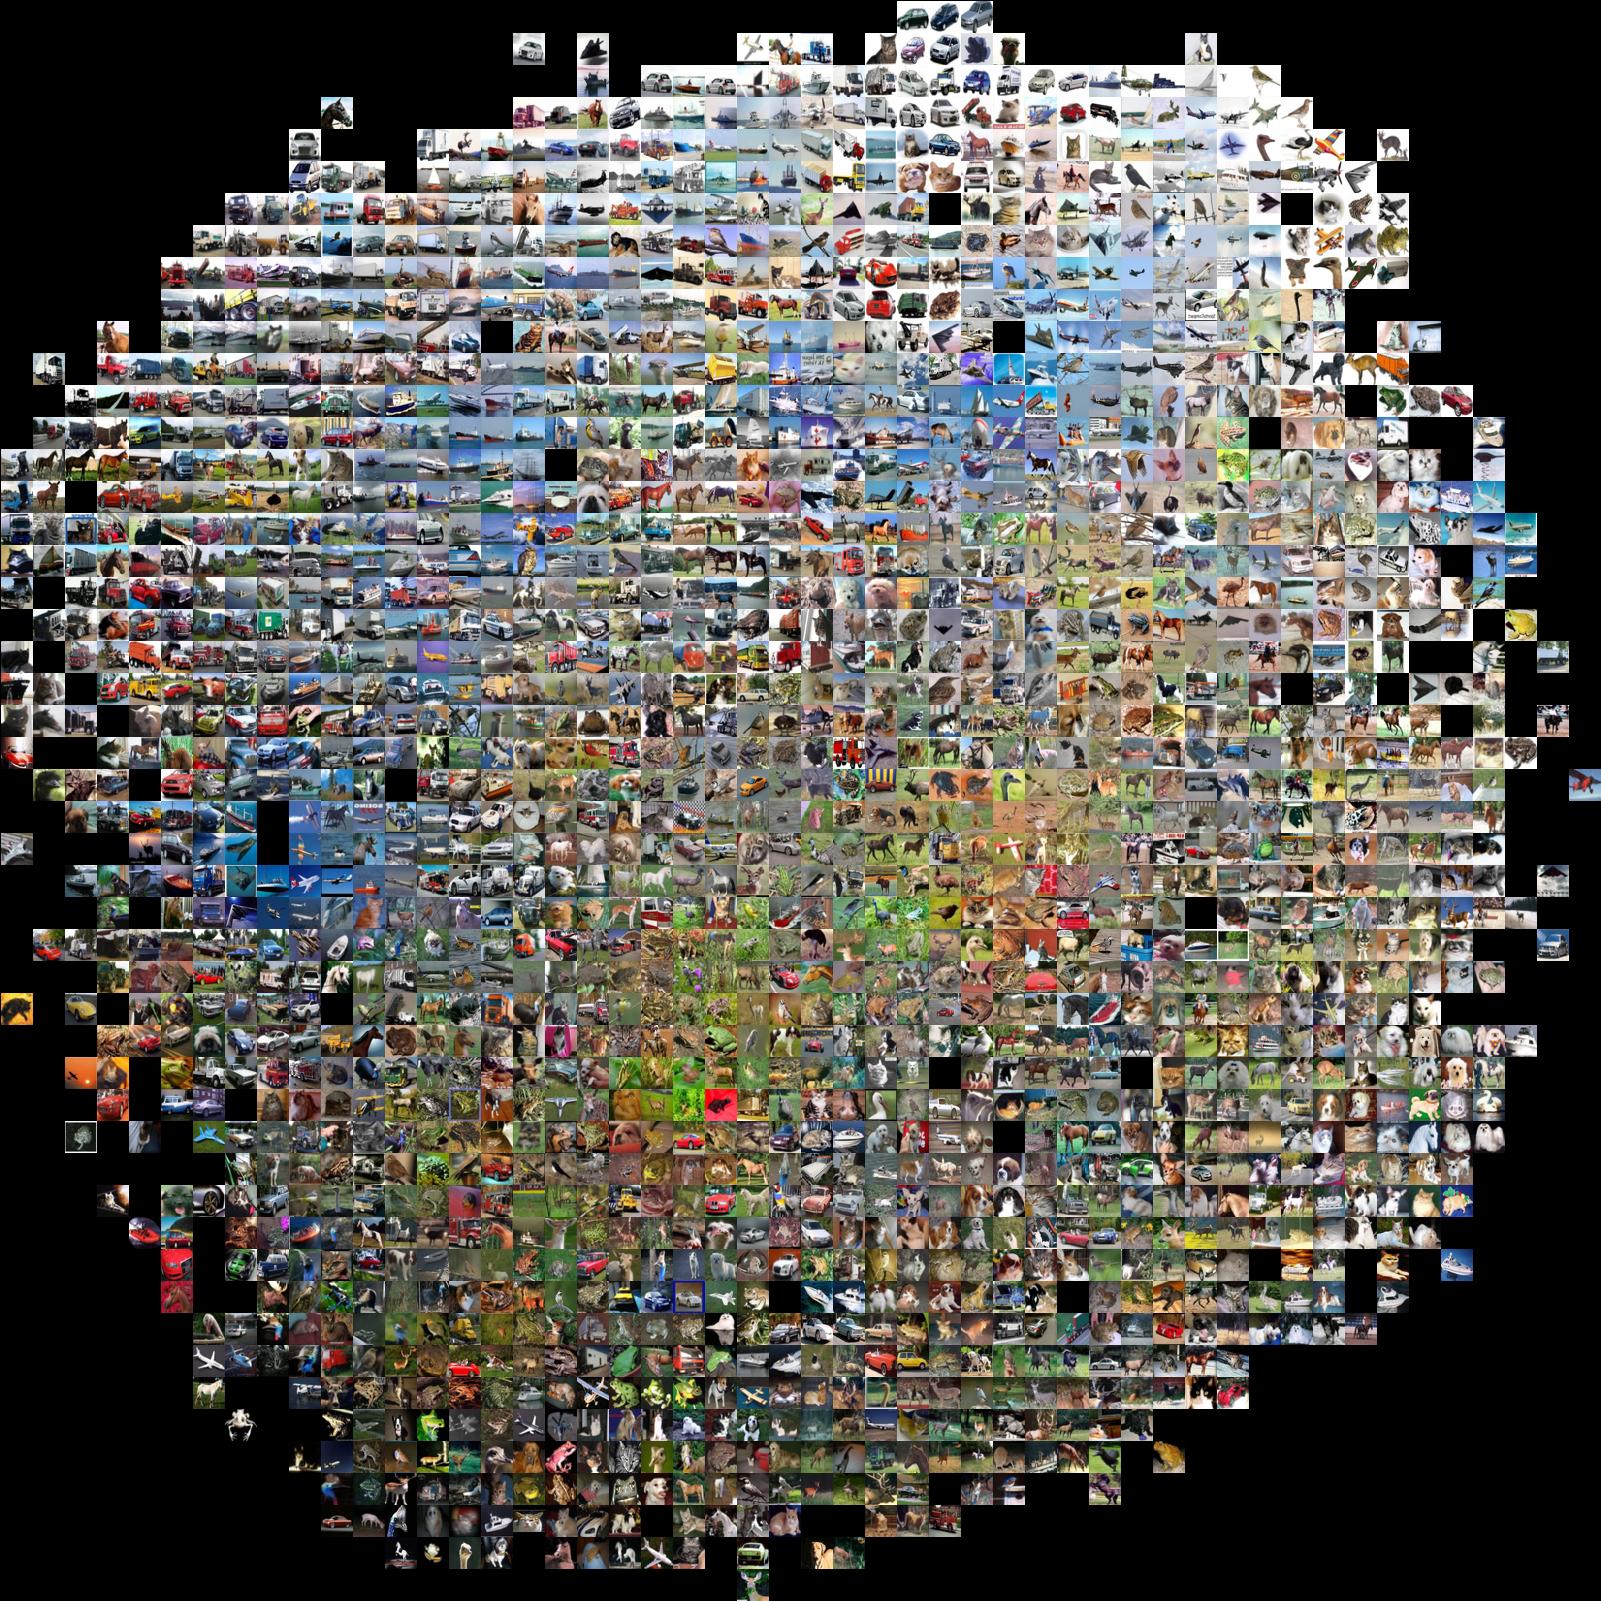
特别要注意的是,彼此相邻的图像更多地取决于图像的一般颜色分布或背景类型,而不是它们的语义标识。例如,可以看到一只狗非常靠近一只青蛙,因为两者恰好都在白色背景上。理想情况下,我们希望所有 10 个类别的图像形成自己的簇,以便同一类别的图像彼此靠近,而不管不相关的特征和变化(例如背景)。然而,为了获得这个属性,我们必须超越原始像素。
小结
总之:
- 本节介绍了图像分类问题:给定一组图像,其中每张图像都有一个类别标签;任务是预测新的测试图像分别属于哪一类,并衡量预测准确率。
- 我们引入了一个简单的分类器,称为最近邻分类器。我们看到有多个超参数(例如 k 的值,或用于比较示例的距离类型)与该分类器关联,并且没有明显的方法来选择它们。
- 我们看到设置这些超参数的正确方法是将训练数据分为两部分:训练集和假测试集,我们称之为验证集。我们尝试不同的超参数值,并保留在验证集上实现最佳性能的值。
- 如果缺乏训练数据是一个问题,我们讨论了一个名为交叉验证的过程,它可以帮助减少估计哪些超参数效果最好的过程中的噪音。
- 一旦找到最佳超参数,我们就会修复它们并在实际测试集上执行单个评估。
- 我们发现最近邻在 CIFAR-10 上的准确率约为 40%。它实现起来很简单,但需要我们存储整个训练集,并且在测试图像上进行评估的代价很高。
- 最后,我们发现在原始像素值上使用 L1 或 L2 距离是不够的,因为距离与图像的背景和颜色分布的相关性比与图像语义内容的相关性更强。
在接下来的讲座中,我们将着手解决这些挑战,并最终得出准确率达到 90% 的解决方案,使我们能够在学习完成后完全丢弃训练集,并且使我们能够在不到一毫秒的时间内评估测试图像。
小结:k 近邻方法的实际应用
如果您希望在实践中应用 kNN(希望不是在图像上,或者可能仅作为基线),请按以下步骤操作:
- 预处理数据:对每个特征(例如图像中的一个像素位置)做标准化,使其均值为 0、方差为 1。后续章节将详细介绍。本节暂未展开这一处理,因为图像像素通常具有相近的性质,各特征的分布不会相差特别大,因此标准化的必要性相对较低。
- 如果数据维度很高,可以考虑降维方法,例如 PCA(维基百科、CS229 资料、博客参考)、NCA(维基百科、博客参考),也可以考虑随机投影。
- 将训练数据随机分割为训练/验证数据。根据经验,70-90% 的数据通常会进入训练集。此设置取决于您拥有多少个超参数以及您期望它们具有多大的影响力。如果有许多超参数需要估计,您应该宁可使用更大的验证集来有效地估计它们。如果您担心验证数据的大小,最好将训练数据分成几部分并执行交叉验证。如果您能负担得起计算预算,那么交叉验证总是更安全(折越多越好,但更昂贵)。
- 针对 k 的多种选择(例如,越多越好)和不同距离类型(L1 和 L2 是很好的候选者),在验证数据(对于所有折,如果进行交叉验证)上训练和评估 kNN 分类器
- 如果您的 kNN 分类器运行时间过长,请考虑使用近似最近邻库(例如 FLANN)来加速检索(以一定的准确性为代价)。
- 记下给出最佳结果的超参数。存在一个问题,您是否应该使用具有最佳超参数的完整训练集,因为如果您要将验证数据并入训练集,最佳超参数可能会发生变化(因为数据的大小会更大)。实际上,在最终分类器中不使用验证数据并在估计超参数时将其视为燃烧会更干净。评估测试集上的最佳模型。报告测试集准确性并将结果声明为 kNN 分类器对您的数据的性能。
延伸阅读
以下是一些您可能会感兴趣的进一步阅读的(可选)链接:
-
关于机器学习的一些有用知识,其中特别是第 6 节相关,但整篇论文强烈推荐阅读。
-
识别和学习对象类别,ICCV 2005 上的对象分类短期课程。